대학교 AI 챗봇 프로젝트 회고 1편 - 강냉봇 기획, RAG 설계, 개발 후기
**강냉봇을 처음 기획한 시점은 2025년 3월이었다.
이 프로젝트는 학교에 흩어져 있는 학사정보를 학생이 자연어로 쉽게 묻고 답을 받을 수 있도록 만든 대학생 전용 AI 챗봇 프로젝트였다. 학사일정, 졸업요건, 수업 정보, 셔틀버스 시간표처럼 분명 존재하는 정보조차 학생들은 매번 학교 홈페이지, PDF, 공지사항을 뒤져야 했고, 그 과정에서 정보 접근 비용이 지나치게 커지고 있었다. 나는 이 불편이 단순한 검색의 문제가 아니라 대학 생활 전반의 정보 비대칭 문제라고 봤고, 그래서 강냉봇을 학교 정보를 대화형으로 안내하는 대학생 맞춤형 챗봇으로 기획하게 됐다.
**
서비스: https://kang-naeng-bot-fe.vercel.app/
[강냉봇 - 강남대학교 AI 도우미
kang-naeng-bot-fe.vercel.app](https://kang-naeng-bot-fe.vercel.app/login)
강냉봇을 기획하게 된 배경
당시는 지금처럼 “에이전트”라는 말이 대중적으로 많이 쓰이기 전이었고, 나 역시 LangChain으로 챗봇을 만들어보면서 LLM이 어떤 식으로 동작하는지 이해해가던 단계였다. 그 무렵 관공서나 은행 등 여러 곳에서 챗봇을 출시하고 있었지만, 실제로 써보면 여전히 룰베이스에 가까운 챗봇이 많다고 느꼈다. 정해진 버튼을 누르거나 정해진 표현을 입력해야만 원하는 답을 얻는 경우가 많았고, 사람과 자연스럽게 대화하는 느낌과는 거리가 있었다.
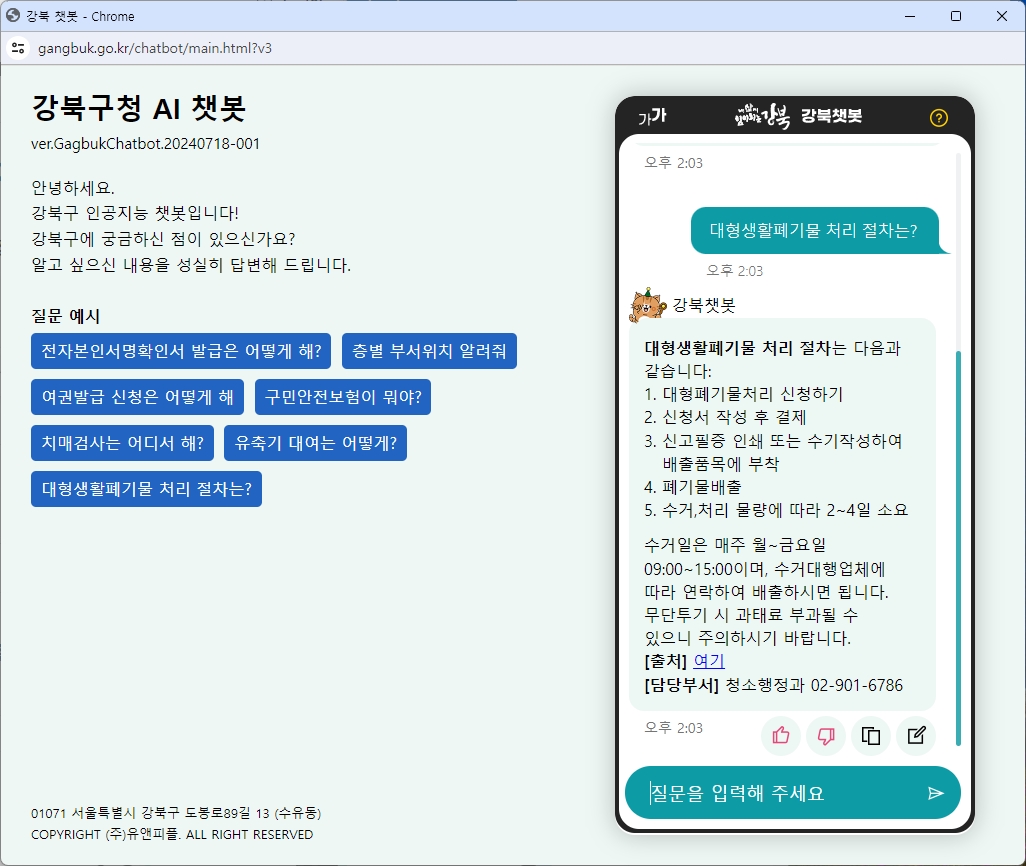
나는 그때부터 “사람과 대화하는 듯한 경험을 원하는 수요는 분명히 있을 것”이라고 생각했다. 그리고 마침 캡스톤디자인 수업이 시작되면서, 이 기회에 대학생 전용 챗봇을 만들어보자는 생각을 하게 됐다.
이 아이디어는 없는 수요를 억지로 만드는 게 아니었다. 나는 4학년 1학기 동안 신입생 멘토 활동을 했고, 2, 3학년 때는 동아리 회장과 부회장을 맡았다. 동아리를 운영하면서 가장 중요한 것 중 하나는 결국 1학년 신입생들과 접점을 만드는 일이라는 걸 자연스럽게 체감했다. 그 과정에서 신입생들과 친해질 기회도 많았고, 학교생활에 대한 질문도 정말 많이 받았다.
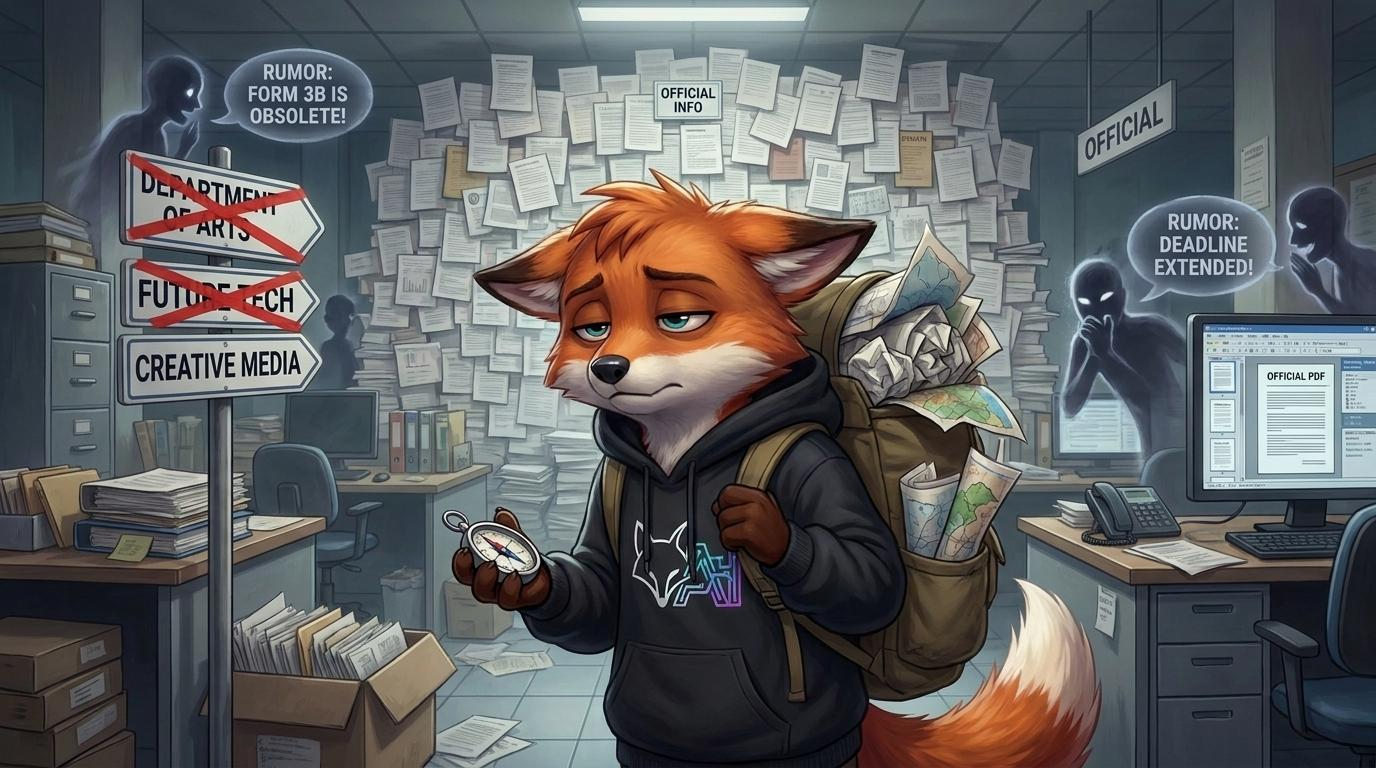
그 질문들을 듣다 보면 공통점이 있었다. 분명 학교 홈페이지나 PDF, 안내자료에 정보는 다 있는데, 막상 학생들은 그걸 잘 찾지 못했다. “그거 어디 있어?”라고 알려줘도 다시 찾는 데 어려움을 겪는 경우가 많았다. 게다가 매년 과 이름이나 행정적인 명칭이 바뀌기도 했고, 실제 하는 일은 비슷한데 이름만 바뀐 프로그램도 많았다. 또 졸업요건이나 학사제도처럼 민감한 정보는 정확한 문서보다 구전되는 경우가 많았다. 예를 들어 “25년부터는 졸업 심사가 없어진대” 같은 이야기가 돌면, 그게 다시 “그럼 우리도 없어지는 거야?” 같은 식으로 퍼지는 경우가 많았다. 강의명 변경 문제도 마찬가지였다. 정보는 존재하지만, 학생 입장에서는 그것을 찾고 해석하는 비용이 너무 컸다.
대학생 AI 챗봇 MVP 기능 정의
그래서 처음 강냉봇 V1에서 생각한 핵심은 아주 분명했다.
학교에 흩어져 있는 정보를 한 곳에 모으고, 학생이 자연어로 질문하면 사람과 대화하듯 답해주는 시스템을 만들자는 것이었다.
V1에서 MVP로 우선 넣고 싶었던 기능도 이 문제의식에서 나왔다.
내가 처음 중요하다고 본 기능은 다음과 같았다.

- 학사일정 안내
- 학교 셔틀버스 시간표
- 질문이 모호할 때 대안 제시
- 교수님 연락처 및 이메일
- 졸업요건에 대한 자연스러운 대화형 응답
V1의 목표는 “모든 걸 다 하는 AI”가 아니라, 학생들이 학교생활에서 반복적으로 부딪히는 기본 질문을 사람처럼 풀어주는 챗봇이었다.
하지만 개발을 시작하고 나서 생각이 조금 바뀌었다. 공통 학교 정보만 잘 답하는 것도 의미 있었지만, 거기서 한 걸음 더 나아가 개인화가 들어가면 훨씬 강력해질 수 있겠다고 느꼈다. 내가 그때부터 그리고 싶었던 모습은 이런 것이었다.
“이번 주에 뭐 해야 해?”
“네가 듣는 OO 과목은 이번 주에 이런 내용을 들어야 하고, XX 과목에는 이런 과제가 있어.”
즉 단순한 학교 정보 챗봇이 아니라, 학교 정보를 알고 있으면서 동시에 학생 개인의 상황까지 반영해주는 비서형 서비스였다. 지금 돌아보면 이게 강냉봇이 이후 버전들에서 계속 추구하게 되는 방향의 시작이었다고 생각한다.
강냉봇(v.1) 기술 스택과 아키텍처
V1의 구현은 빠른 프로토타이핑에 초점이 맞춰져 있었다.
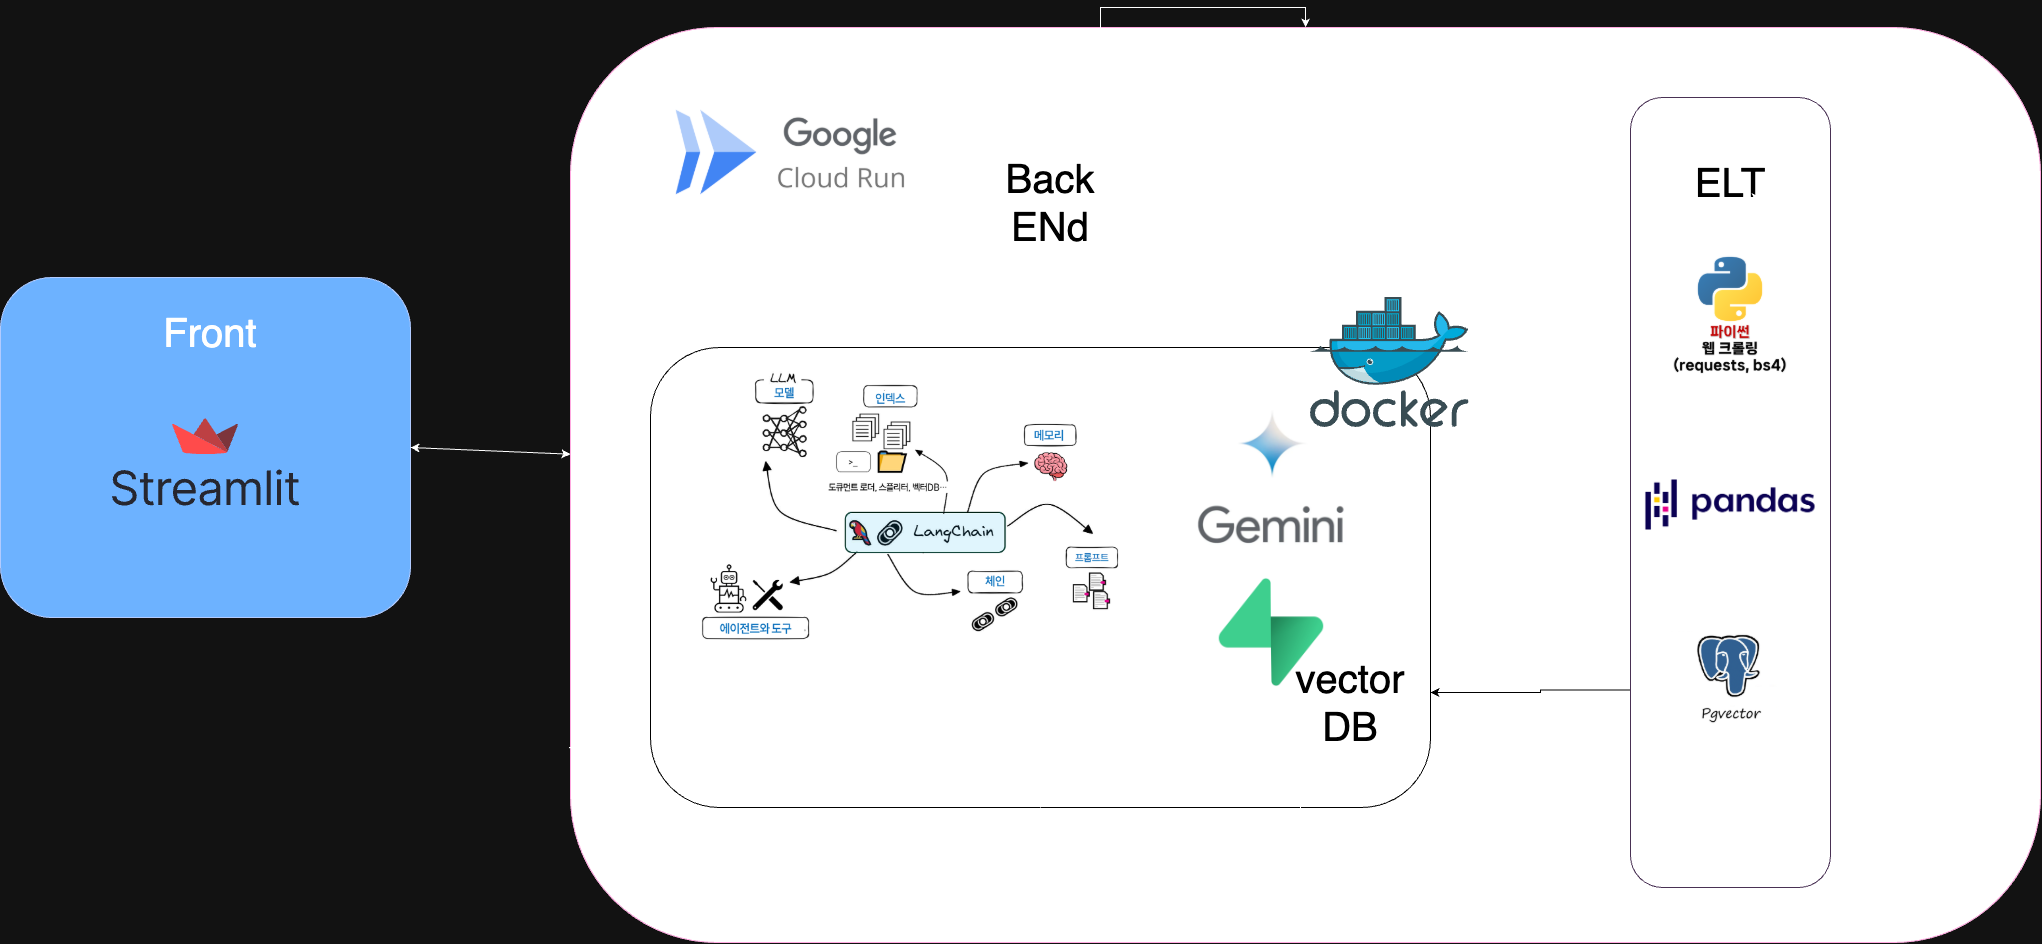
프론트엔드는 내가 강하지 않았기 때문에 Streamlit을 선택했다. 당시 나는 Backend를 공부하다가 LLM 쪽으로 넘어온 상태였고, Frontend는 능숙하게 다루지 못했다. 그래서 UI를 예쁘게 만드는 것보다 “빠르게 돌아가는 화면을 만드는 것”이 중요하다고 판단했고, Streamlit이 가장 현실적인 선택지였다.
에이전트/오케스트레이션 구조는 LangGraph를 선택했다. 처음에는 LangChain도 써봤지만, 순차적인 체인 구조만으로는 한계가 있다고 느꼈다. 내가 만들고 싶은 건 단순히 “검색 -> 답변” 한 줄짜리 흐름이 아니었고, 질문의 성격에 따라 중간에서 라우팅을 하고 다른 흐름으로 보낼 수 있는 구조였다. 그래서 그래프 형태가 더 잘 맞겠다고 생각했다. 그 당시에는 지금처럼 ADK라고 불리는 프레임워크들이 많지 않았기 때문에, 질문을 분기 처리하는 구조를 직접 설계하기 위해 LangGraph를 택했다.
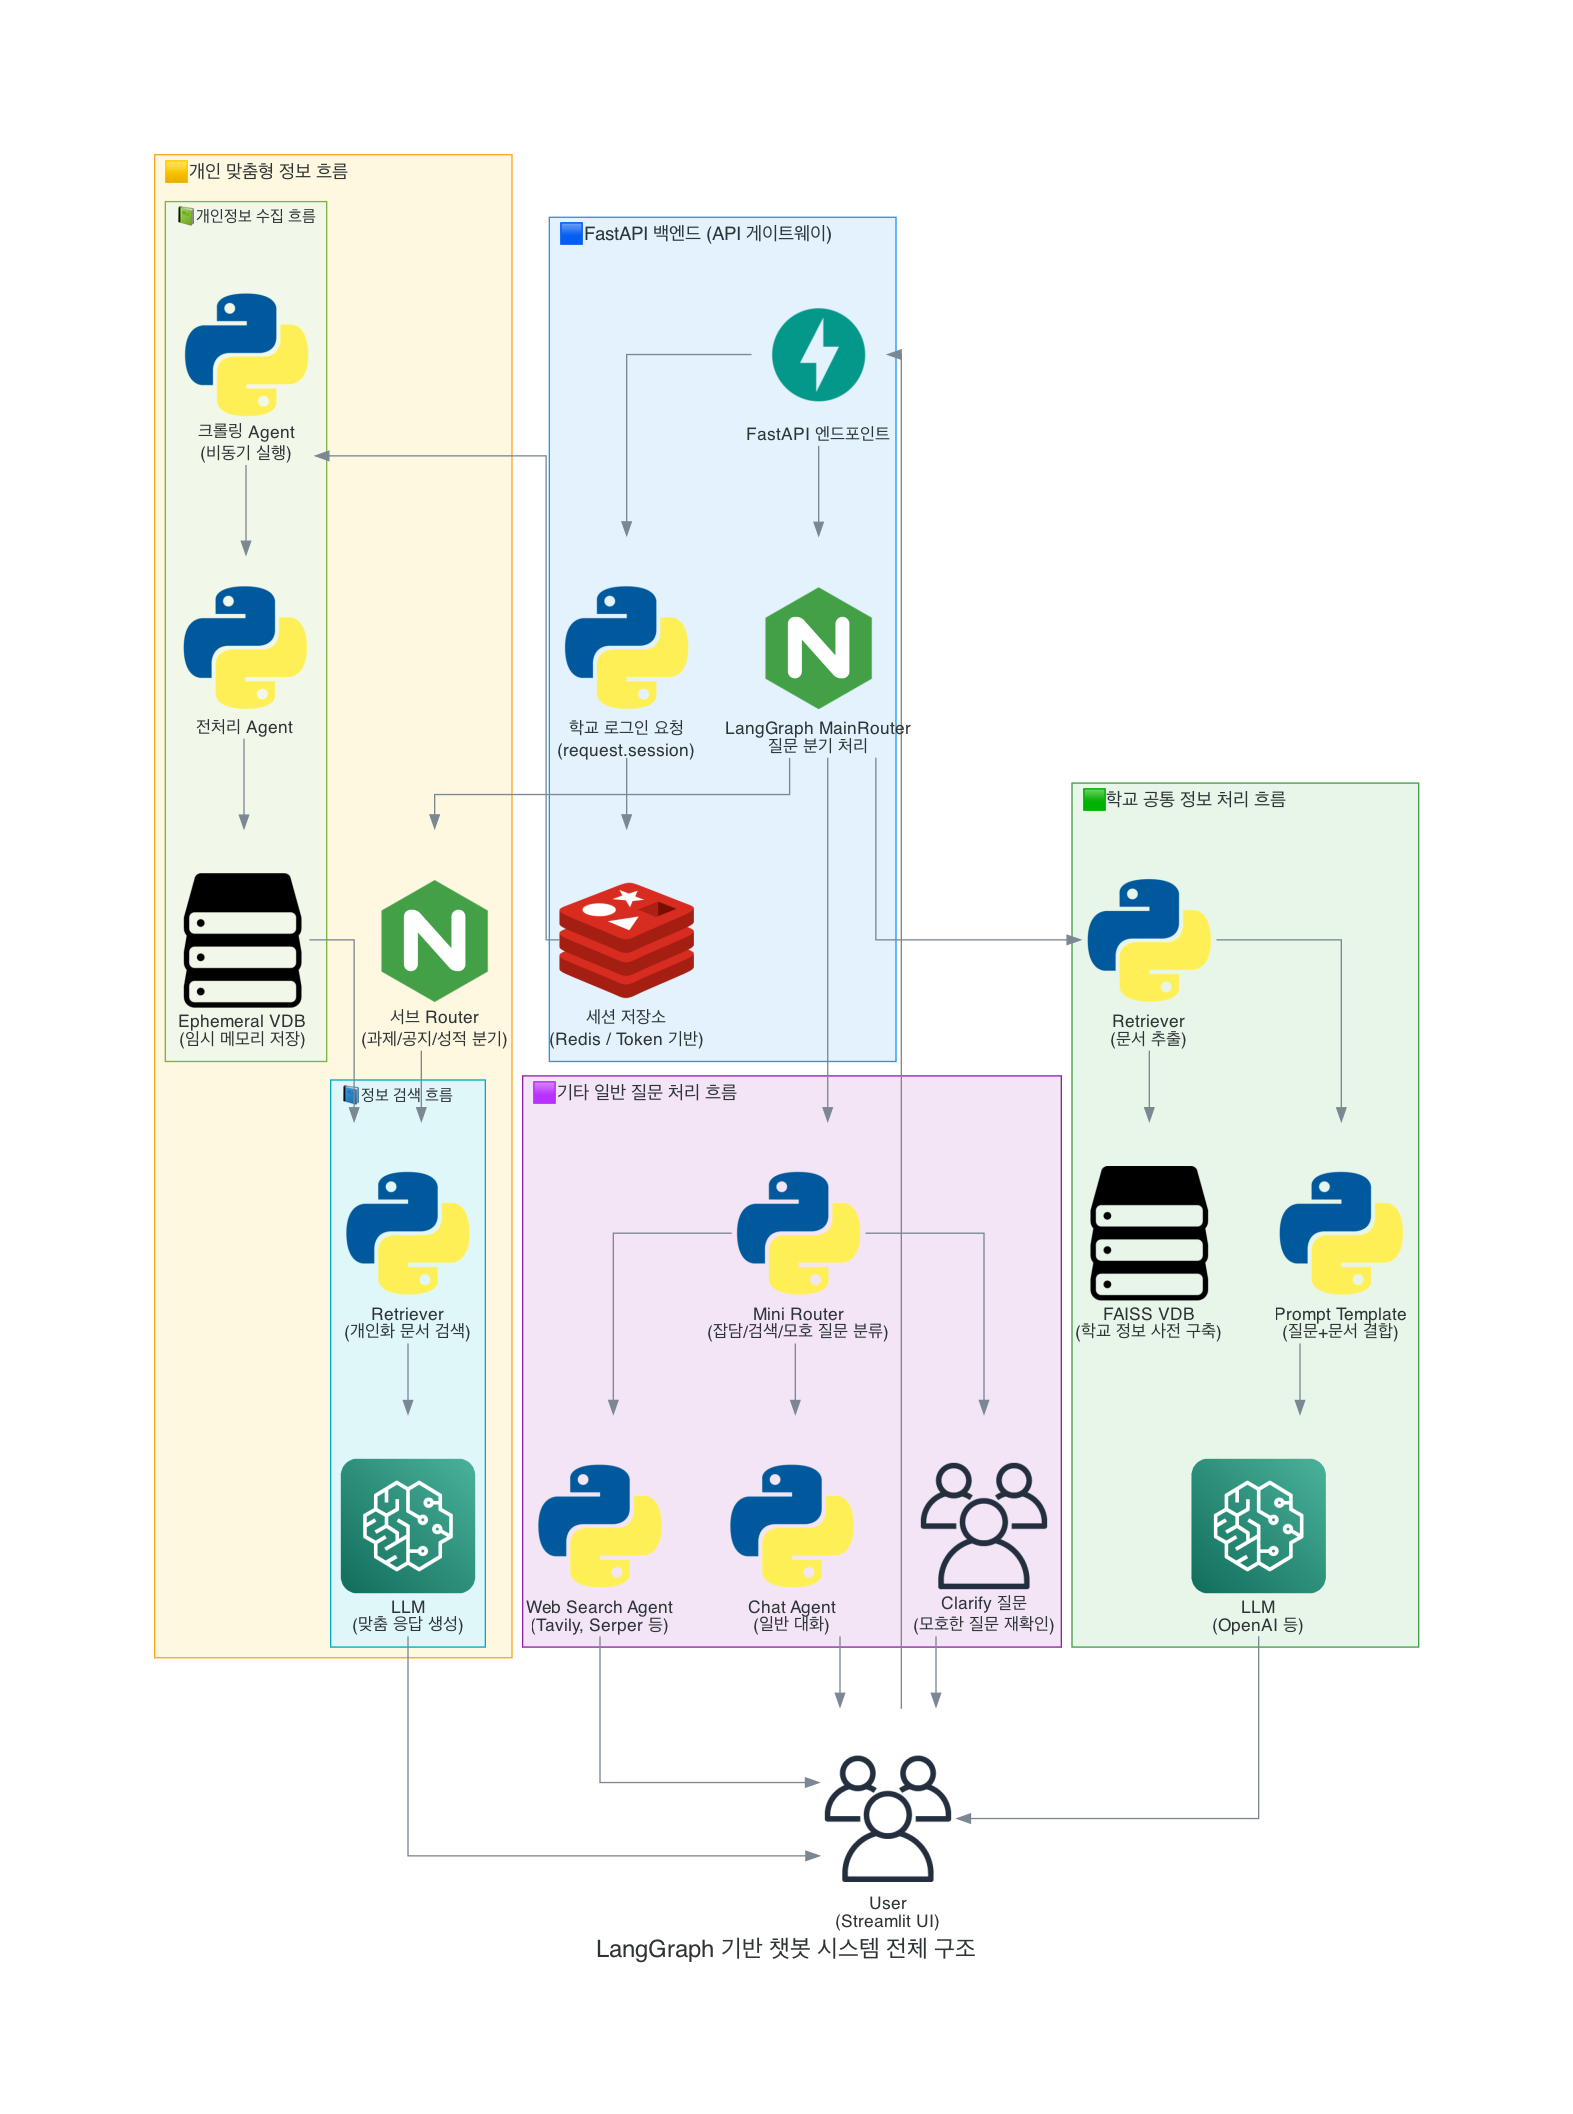
이때 질문 흐름은 3단계로 나누었다.

- 학교 공통 정보 처리
- 개인 정보 처리
- 일반적인 질의 처리
이 분기는 V1의 핵심 설계였다. 그리고 실제 v1 코드에도 이 구조가 남아 있다. /src/chatbot_graph.py와 router_agent.py를 보면 질문을 personal/common/general 세 흐름으로 분류하고, 그에 따라 다른 agent가 처리하도록 만든 구조를 확인할 수 있다. 지금 보면 다소 단순해 보일 수 있지만, 당시에는 “질문은 모두 같지 않고, 흐름에 따라 다르게 다뤄야 한다”는 판단이 분명히 있었던 셈이다.
Supabase를 선택한 이유는 “벡터 저장에 특화된 DB”라서라기보다, 빠른 프로토타이핑을 위해서였다. 인증, 저장, 실험 환경 구성까지 빠르게 해볼 수 있다는 점에서 유리했고, 당시 프로젝트 속도와 현실적인 구현 난이도를 생각했을 때 적절한 선택이었다.
RAG 파이프라인 설계와 검색 최적화
실제로 V1에서 내가 가장 시간을 많이 쓴 부분은 RAG 파이프라인이었다.
처음엔 막연히 “학교 정보를 넣고 검색하면 되겠지”라고 생각했는데, 실제로는 전혀 그렇지 않았다. RAG에서 가장 큰 문제는 결국 사용자의 의도를 어떻게 읽고, 어떤 키워드로 검색할 것인가였다. 그냥 질문을 그대로 검색에 넣으면 결과가 엉망이 되는 경우가 많았다. 그래서 어느 정도 템플릿을 정해놓고, 질문의 핵심을 뽑아서 검색어를 정제하고, 필요하면 다시 검색하게 하는 프로세스를 넣으려고 했다.
이 부분도 v1 코드에서 확인된다. _deprecated/src/agents/personal_agent.py에는 사용자의 질문에서 과목명을 바로 검색하지 않고, 먼저 normalize_course_name_with_llm 같은 방식으로 과목명을 추론한 뒤 검색하는 로직이 들어 있다. 또 _deprecated/backend/app/services/chat.py 쪽에는 질문에서 과목명 핵심, 주요 키워드, 시간 표현을 추출해 검색에 더 적합한 형태로 다듬으려는 흔적이 남아 있다. 즉 V1에서 이미 단순 벡터 검색만 붙인 것이 아니라, “의도 해석 -> 흐름 분기 -> 검색 쿼리 보정”을 고민하고 있었던 것이다.
아래는 강냉봇v1의 전체 시스템 아키택쳐이다.
캡스톤 시연 당시 가장 중요하게 생각했던 장면도 분명했다.
하나는 졸업요건 질문에 자연스럽게 답하는 장면이었다. 또 하나는 사용자가 어떤 수업을 듣고 있는지를 알고 있다는 느낌을 주는 장면이었다. 그 두 가지는 내가 생각한 강냉봇의 핵심 철학과도 맞닿아 있었다.
- 사람처럼 대화하는 경험
- 학교 정보를 한 곳에서 처리하는 것
강냉봇 v1의 한계와 v2로 넘어간 이유
다만 V1은 분명한 한계도 있었다.
기본적인 기능들은 돌아갔지만, 실시간으로 올라오는 공지사항들을 ETL하는 프로세스는 만들지 못했다. 그리고 로그인을 할 때마다 크롤링을 다시 해야 하는 문제도 해결하지 못했다. 사용자 경험 측면에서는 솔직히 완전히 엉망이었다. 시연은 가능했지만, 실제 서비스라고 부르기에는 너무 거친 상태였다.
지금 돌아보면 V1에서 가장 아쉬웠던 판단은 개인화에 너무 빨리 욕심을 냈던 점이다. 개인화가 들어가면 훨씬 강력해지는 건 맞지만, 실제로는 그때부터 DB 구조, 메모리 시스템, 사용자 상태 관리 같은 문제를 전부 같이 고민해야 했다. 당시에는 그 복잡성을 충분히 감당할 준비가 되어 있지 않았는데, 개인화까지 같이 잡으려다 보니 구조가 많이 흔들렸다.
그리고 이것이 결국 V2로 넘어가게 된 중요한 이유가 되었다.
V1에는 쓸데없는 UX가 많았고, 본질보다 주변적인 실험이 붙어 있는 부분도 많았다. 그래서 V2에서는 “학교생활을 도와주는 챗봇”이라는 본질에 더 집중하고 싶었다. 마침 그 시기부터 멀티에이전트와 에이전트 자체에 대한 관심이 커졌고, 실제로 무언가를 대신 수행해주는 서비스들도 많이 등장하기 시작했다.
A2A 같은 흐름도 나오고, Google에서 ADK라는 프레임워크를 출시하면서 나 역시 에이전트를 진지하게 공부해볼 수 있는 타이밍이라고 느꼈다. 단순히 답변만 하는 챗봇이 아니라, 나중에는 교수님께 메일까지 보내는 서비스까지 연결되면 좋겠다는 생각도 하게 됐다. 물론 그건 RAG나 기본 챗봇 구조를 먼저 충분히 다뤄본 이후의 이야기였다.
프로젝트 회고: 무엇을 배웠는가
결국 V1은 완성된 서비스라기보다, 내가 풀고 싶은 문제를 가장 직접적으로 붙잡고 실험한 버전이었다.
돌아보면 구조적으로 미숙한 부분도 많았고 UX도 거칠었지만, 강냉봇의 출발점으로서는 분명 의미가 있었다. 무엇보다도 이 시기에 “학교 정보는 단순히 검색되는 것이 아니라, 학생의 질문 맥락 안에서 다시 해석되어야 한다”는 사실을 배운 것이 이후 버전들로 이어지는 가장 중요한 자산이 되었다고 생각한다.
아래는 강냉봇 v2 챗봇이다. v1 Code 들은 _deprecated 폴더 아래에 들어있다.
https://github.com/CodeBBakGoSu/kangnam_Unv_chatbot
[GitHub - CodeBBakGoSu/kangnam_Unv_chatbot
Contribute to CodeBBakGoSu/kangnam_Unv_chatbot development by creating an account on GitHub.
github.com](https://github.com/CodeBBakGoSu/kangnam_Unv_chatbot)